
GPTBot, OAI-SearchBot, quels robots d'IA laisser passer dans votre robots.txt ?
Les IA envoient plusieurs robots sur votre site, et ils ne font pas tous la même chose. Voici lesquels servent à l'entraînement, lesquels décident de votre présence dans les réponses, comment les régler dans votre robots.txt, et pourquoi votre pare-feu les bloque peut-être déjà.
Propulsée par Morgane Plantrou & Alexandre Montenon
La réponse en bref
Le robots.txt indique aux robots ce qu'ils peuvent parcourir, sans rien protéger. Les éditeurs d'IA séparent leurs robots d'entraînement (GPTBot, ClaudeBot, CCBot, meta-externalagent), de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot pour les aperçus IA) et de visite à la demande (ChatGPT-User, Claude-User, Perplexity-User). Pour être cité, il faut laisser passer les robots de recherche ; bloquer l'entraînement est un choix d'affaires. Google-Extended n'a aucun effet sur Google Search. Vérifiez aussi votre pare-feu : Cloudflare bloque les robots d'IA par défaut pour les nouveaux domaines depuis juillet 2025.
Le 1er juillet 2025, Cloudflare a changé une règle discrète aux conséquences énormes. Le prestataire, qui protège une grande partie des sites du web, a annoncé qu'il bloquait désormais par défaut les robots d'IA, et que chaque nouveau domaine se verrait demander s'il veut les autoriser.
Résultat : des entreprises qui veulent être citées par ChatGPT ferment la porte à ses robots sans le savoir. D'autres la laissent grande ouverte à des robots dont elles ne veulent pas.
La page GEO technique survole le sujet. Ici, je descends dans le détail : qui sont ces robots, ce que fait chacun, et quelles lignes écrire selon ce que vous cherchez.
Le robots.txt, c'est quoi exactement ?
Un simple fichier texte, posé à la racine du site (votresite.fr/robots.txt), qui dit aux robots ce qu'ils ont le droit de parcourir. Sa syntaxe est normalisée depuis septembre 2022 par la RFC 9309, le Robots Exclusion Protocol.
Deux mots suffisent pour la plupart des règles : User-agent (le nom du robot visé) et Disallow ou Allow (le chemin interdit ou permis).
Attention à un malentendu tenace. La norme le dit elle-même : ces règles ne sont pas une forme d'autorisation d'accès.
Le robots.txt est une consigne, respectée par les robots polis. Il ne protège rien. Une page privée se protège par un mot de passe, pas par une ligne dans ce fichier.
Trois familles de robots d'IA à ne pas confondre
Tout le reste de la page découle de cette distinction. Les grands acteurs de l'IA n'envoient pas un robot, mais plusieurs, avec des missions très différentes.
- ➭ Les robots d'entraînement collectent des pages pour entraîner les futurs modèles. Les bloquer, c'est dire « n'apprenez pas sur mon contenu ».
- ➭ Les robots de recherche indexent le web pour que l'IA puisse citer et lier des pages dans ses réponses. Les bloquer, c'est sortir des sources possibles.
- ➭ Les récupérateurs à la demande visitent une page parce qu'un utilisateur l'a demandé dans la conversation. Comme l'action vient d'un humain, plusieurs éditeurs préviennent qu'ils ne suivent pas toujours le robots.txt.
Toute la finesse d'un bon réglage consiste à traiter ces familles séparément. Bloquer « l'IA » en bloc revient souvent à se retirer des réponses tout en continuant à être lu d'une autre façon.
Le tableau des crawlers IA, robot par robot
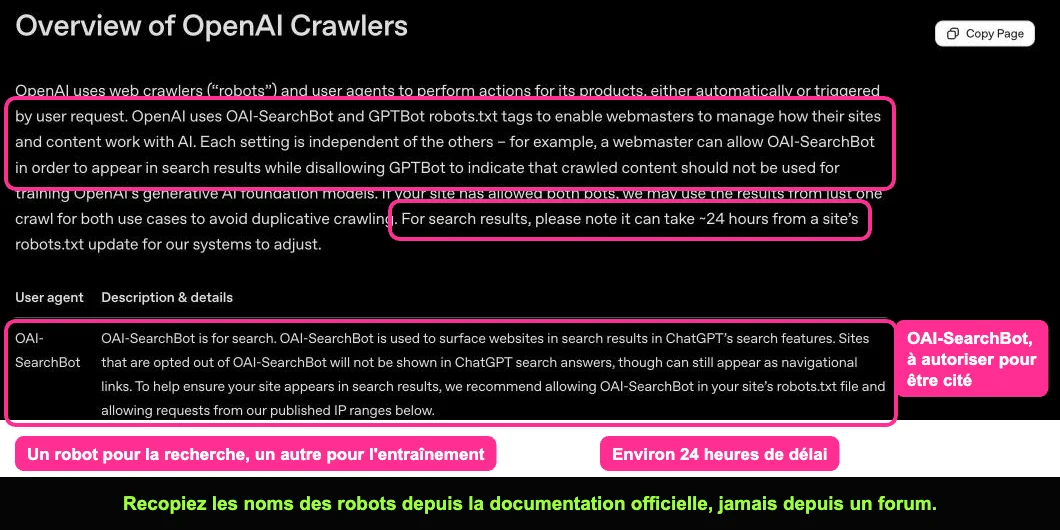
Voici les noms exacts, tels que publiés par chaque éditeur dans sa documentation officielle en octobre 2026. Recopiez-les à la lettre : une faute de frappe, et la règle ne s'applique à personne.
| Éditeur | Robot | Rôle | Doc officielle |
|---|---|---|---|
| OpenAI | GPTBot | Entraînement des modèles | developers.openai.com, page Bots |
| OpenAI | OAI-SearchBot | Recherche, fait apparaître les sites dans ChatGPT | Idem |
| OpenAI | ChatGPT-User | Visite à la demande d'un utilisateur | Idem |
| Googlebot | Index de Google, y compris aperçus IA et mode IA | developers.google.com, robots d'indexation | |
| Google-Extended | Jeton, pas un robot : entraînement de Gemini et ancrage dans d'autres systèmes | Idem | |
| Anthropic | ClaudeBot | Entraînement des modèles | support.claude.com |
| Anthropic | Claude-SearchBot | Recherche, qualité des résultats | Idem |
| Anthropic | Claude-User | Visite à la demande d'un utilisateur | Idem |
| Perplexity | PerplexityBot | Recherche, pas d'entraînement selon l'éditeur | docs.perplexity.ai, page Bots |
| Perplexity | Perplexity-User | Visite à la demande, ignore en général le robots.txt | Idem |
| Apple | Applebot | Spotlight, Siri, Safari, et entraînement possible | support.apple.com |
| Apple | Applebot-Extended | Jeton de refus d'entraînement, ne visite aucune page | Idem |
| Meta | meta-externalagent | Entraînement et indexation | developers.facebook.com |
| Meta | meta-externalfetcher | Visite à la demande, peut ignorer le robots.txt | Idem |
| Common Crawl | CCBot | Archive ouverte du web, réutilisée pour entraîner des modèles | commoncrawl.org |
Les trois pièges du tableau
Google-Extended ne touche pas à Google Search. Google précise que ce jeton n'a aucun effet sur l'inclusion d'un site dans la recherche ni sur son classement. Les aperçus IA et le mode IA dépendent de Googlebot. Bloquer Google-Extended ne vous sort donc pas des aperçus IA, mais peut réduire l'usage de vos pages pour ancrer les réponses de Gemini.
ChatGPT-User ne sert pas à la recherche. OpenAI indique que les règles du robots.txt peuvent ne pas s'appliquer à ce robot, puisque l'action vient d'un utilisateur. Pour apparaître ou non dans ChatGPT Search, c'est OAI-SearchBot qu'il faut régler, et OpenAI compte environ 24 heures pour qu'un changement soit pris en compte.
Anthropic a trois robots, pas un. Sa page d'aide détaille ClaudeBot, Claude-User et Claude-SearchBot, et précise que bloquer Claude-SearchBot peut réduire la présence de vos pages dans les résultats de recherche de Claude.
Trois robots.txt prêts à adapter
Trois situations, trois fichiers. Les lignes qui commencent par un dièse sont des commentaires, ignorés par les robots.
Cas 1, tout ouvert
Si votre fichier ne mentionne aucun robot d'IA, ils sont tous autorisés. Rien à écrire, donc. C'est le réglage logique pour une entreprise qui veut un maximum de visibilité.
# Tous les robots sont autorisés
User-agent: *
Allow: /

Sitemap: https://www.votresite.fr/sitemap.xml
Cas 2, visible dans les réponses, absent des entraînements
Le compromis le plus demandé par les éditeurs de contenu. On ferme la porte aux robots d'entraînement, on la laisse ouverte aux robots de recherche.
# Refus de l'entraînement
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: CCBot
Disallow: /

# Recherche autorisée
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Allow: /
J'ai volontairement laissé Google-Extended de côté : le bloquer ne vous retire pas des aperçus IA, mais peut vous écarter des réponses de Gemini. À trancher selon vos priorités.
Cas 3, une zone privée et un robot trop gourmand
# Espace client exclu pour tous
User-agent: *
Disallow: /espace-client/

# Ralentir ClaudeBot
User-agent: ClaudeBot
Crawl-delay: 1
Anthropic accepte la directive Crawl-delay pour ClaudeBot, ce qui n'est pas le cas de tous les robots. Et pour l'espace client, rappelez-vous la règle : un mot de passe, toujours.
Le piège à éviter
Un robot cherche d'abord un groupe qui porte son nom. S'il en trouve un, il ignore le groupe « User-agent: * ». Si vous ajoutez un bloc pour GPTBot, recopiez dedans les interdictions générales qui doivent aussi le concerner.
Pare-feu et Cloudflare, le blocage que vous n'avez pas écrit
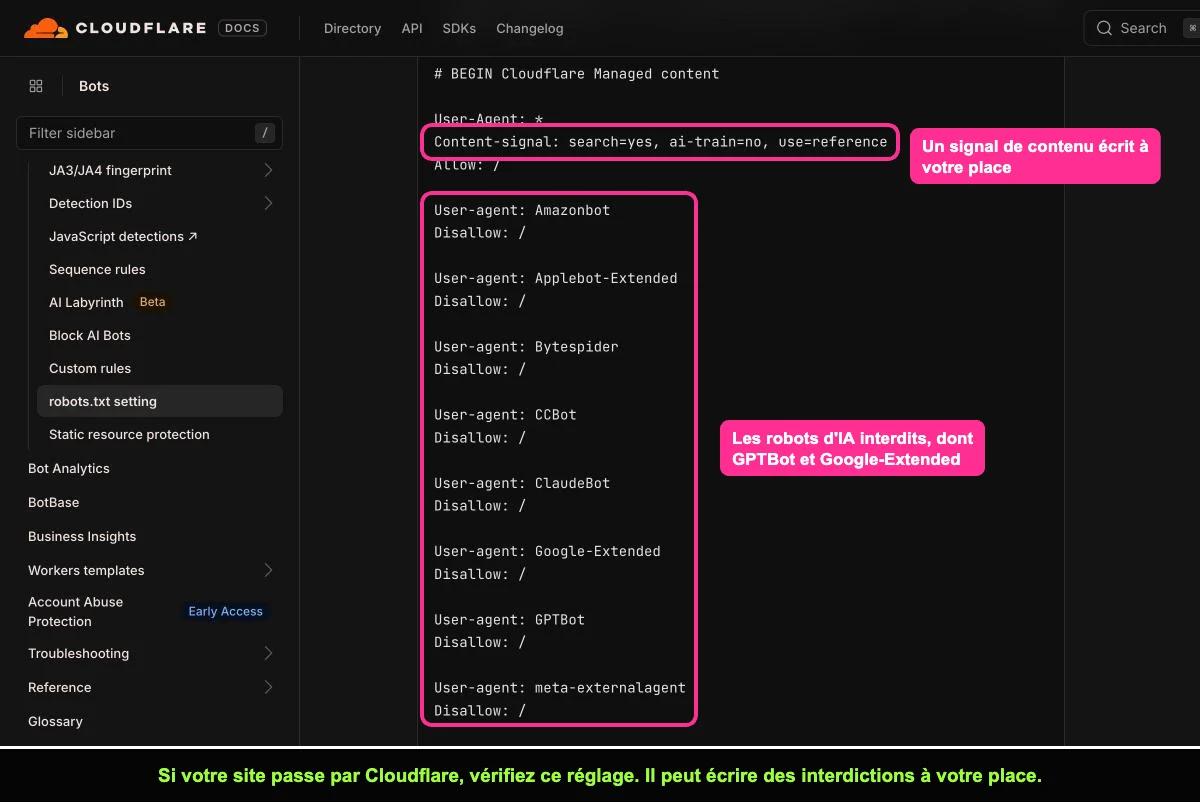
Votre robots.txt peut être parfait et vos pages invisibles quand même. Le blocage se joue parfois un étage plus haut, dans le pare-feu ou le réseau de diffusion (CDN) qui protège le site.
Chez Cloudflare, deux réglages méritent un coup d'œil.
- ➭ Le blocage des robots d'IA, proposé par défaut aux nouveaux domaines depuis juillet 2025, et réversible à tout moment depuis le tableau de bord.
- ➭ Le robots.txt géré, qui ajoute automatiquement des interdictions pour GPTBot, ClaudeBot, CCBot, Google-Extended et d'autres, ainsi qu'une ligne de « signaux de contenu ». Cloudflare a présenté cette politique le 24 septembre 2025 et indiquait alors plus de 3,8 millions de domaines utilisant ce fichier géré.
Ces signaux distinguent trois usages : search (index et liens), ai-input (réponses d'IA en temps réel) et ai-train (entraînement). Une nuance utile, mais déclarative : rien n'oblige un robot à les respecter.
Le respect, justement, reste un point faible. Le 4 août 2025, Cloudflare a accusé Perplexity d'utiliser des robots non déclarés pour contourner des blocages, et l'a retiré de sa liste de robots vérifiés. Encore un motif pour surveiller vos journaux serveur.
Quels robots laisser passer selon votre objectif ?
Ma position est simple pour une entreprise qui vit de sa notoriété : ouvrez les robots de recherche, sans discussion. Pour l'entraînement, c'est un choix d'affaires, pas un réglage technique.
| Votre objectif | Robots de recherche | Robots d'entraînement |
|---|---|---|
| Être cité par les IA (PME, services, e-commerce) | Ouverts | Ouverts, pour exister aussi dans la mémoire des modèles |
| Vendre du contenu (média, éditeur) | Ouverts, si vous voulez du trafic | Fermés, ou négociés |
| Protéger un savoir-faire publié | À arbitrer page par page | Fermés |
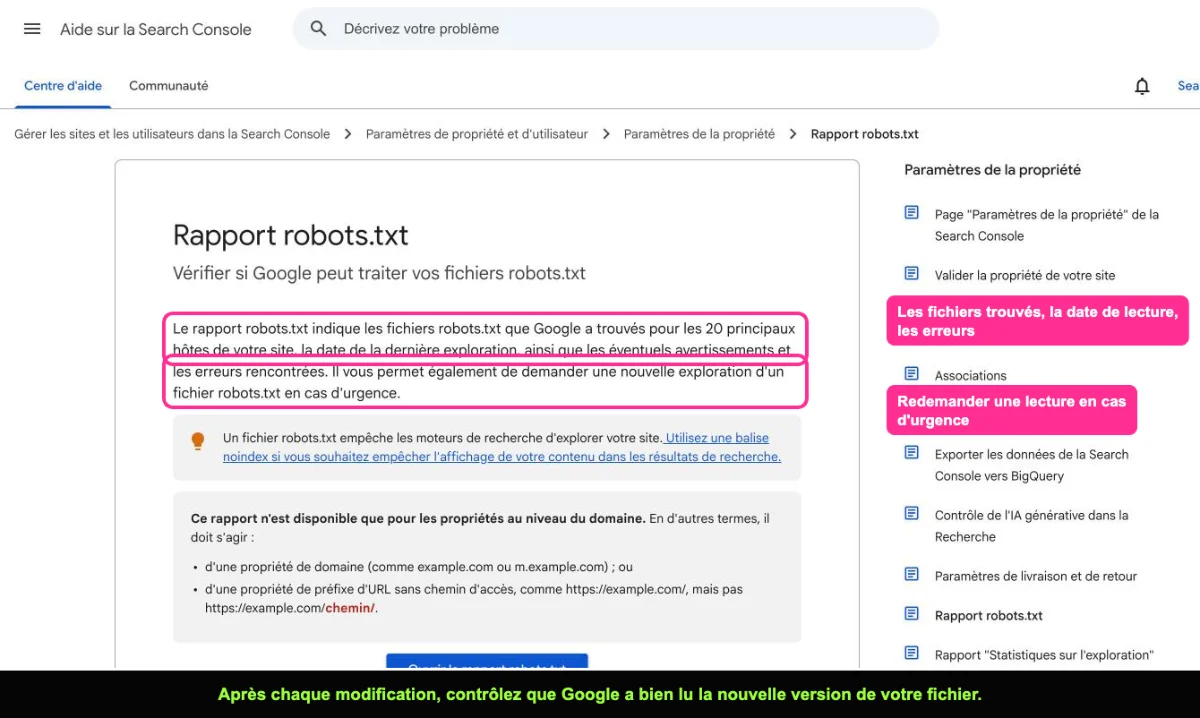
Une fois le réglage choisi, vérifiez-le. Le rapport robots.txt de la Search Console montre la version que Google a récupérée et ses éventuelles erreurs. Et si vous publiez aussi un fichier llms.txt, gardez en tête qu'il ne remplace pas le robots.txt : l'un oriente, l'autre autorise.
Le robots.txt n'est qu'une ligne de la checklist GEO, mais c'est la première : si la porte est fermée, aucun contenu ne compte.
À vous de jouer
Vous voulez apparaître dans ChatGPT Search sans servir à l'entraînement. Que faites-vous ?
GPTBot sert à l'entraînement, OAI-SearchBot à la recherche : on les règle séparément.
Bloquer Google-Extended vous retire-t-il des aperçus IA de Google ?
Google précise que Google-Extended n'a aucun effet sur l'inclusion dans la recherche.
Votre robots.txt autorise tout, mais aucun robot d'IA ne passe. Où regardez-vous ?
Un pare-feu comme celui de Cloudflare peut bloquer les robots d'IA en amont du robots.txt.
Pas sûr de ce que votre site laisse passer ?
>>> Je fais vérifier mon robots.txt et mon pare-feuCe qu'il faut retenir
- ➭ Le robots.txt est une consigne, pas une protection : une page privée se protège par mot de passe.
- ➭ Distinguez trois familles : entraînement, recherche, visites à la demande.
- ➭ Pour être cité, laissez passer OAI-SearchBot, Claude-SearchBot, PerplexityBot et Googlebot.
- ➭ Google-Extended ne touche ni à Google Search ni aux aperçus IA.
- ➭ Vérifiez aussi le pare-feu : Cloudflare propose le blocage des robots d'IA par défaut depuis juillet 2025.
Questions fréquentes
Le robots.txt, c'est quoi ?
Un fichier texte placé à la racine du site qui indique aux robots les pages qu'ils peuvent parcourir. Sa syntaxe est normalisée par la RFC 9309, mais il reste une consigne et non une protection.
Faut-il bloquer GPTBot ?
Seulement si vous refusez que vos contenus servent à entraîner les modèles d'OpenAI. Bloquer GPTBot ne vous retire pas de ChatGPT Search, qui dépend d'OAI-SearchBot.
Quelle différence entre GPTBot et OAI-SearchBot ?
GPTBot collecte des pages pour entraîner les modèles. OAI-SearchBot indexe les sites pour les faire apparaître dans les résultats de recherche de ChatGPT.
Comment savoir si un crawler IA visite mon site ?
Cherchez son nom (GPTBot, ClaudeBot, PerplexityBot…) dans les journaux de votre serveur, et vérifiez dans votre pare-feu ou votre CDN qu'il n'est pas bloqué en amont.