
GEO technique, ce que les données structurées et les robots IA changent vraiment
Balisage schema.org, robots.txt, fichier llms.txt… On entend tout et son contraire sur la technique du GEO. Alors j'ai repris les documentations officielles de Google, OpenAI, Perplexity et Anthropic pour trier ce qui compte et ce qui ne sert à rien.
Propulsée par Morgane Plantrou & Alexandre Montenon
La réponse en bref
Le GEO technique se joue d'abord sur l'accès : une page indexée, servie en HTML, et des robots de recherche des IA (OAI-SearchBot, PerplexityBot, Claude-SearchBot) autorisés dans le robots.txt. Les données structurées restent utiles, mais Google dit lui-même qu'elles ne sont pas requises pour ses réponses IA. Et le fichier llms.txt n'est utilisé par aucun grand moteur à ce jour.
Qu'est-ce qu'on appelle le GEO technique ?
Le GEO technique, c'est tout ce qui permet à une IA de trouver, lire et comprendre vos pages avant même de juger leur contenu.
Concrètement ? Les robots que vous laissez passer. Le HTML que votre serveur renvoie. Et la façon dont vous décrivez votre entreprise aux machines.
C'est la fondation de tout le travail de référencement IA que je mène pour nos clients chez Kontenu. Si un robot ne peut pas lire une page, il ne la citera jamais, aussi brillante soit-elle.
Bonne nouvelle, cette partie-là demande rarement des chantiers énormes. Elle demande surtout de ne pas se tromper de priorités.
Votre site laisse-t-il entrer les robots des IA ?
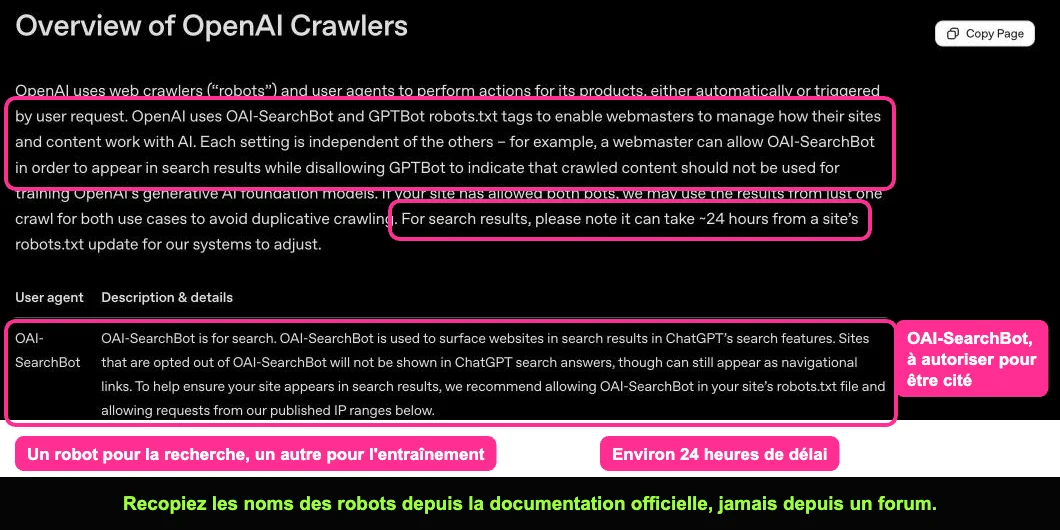
Chaque éditeur d'IA envoie plusieurs robots. Et ils n'ont pas tous le même rôle.
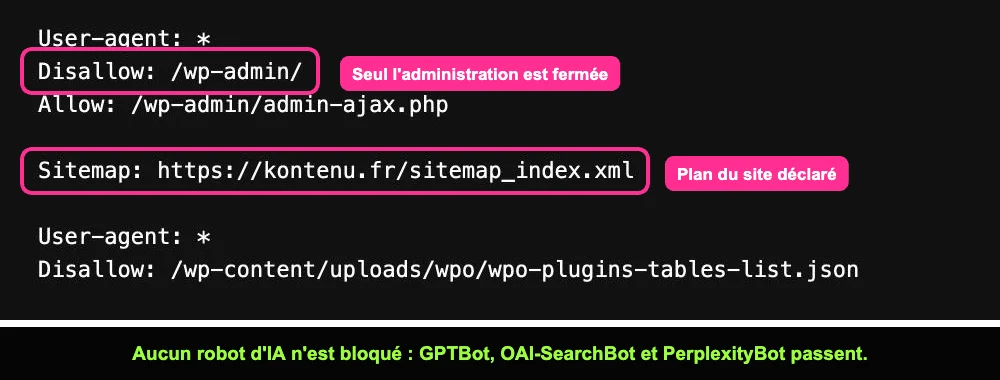
Certains collectent des textes pour entraîner les modèles. D'autres alimentent la recherche en direct. Ce sont ces derniers qui décident si vous pouvez être cité dans une réponse.
| Robot | Éditeur | À quoi il sert | Si vous le bloquez |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Faire apparaître les sites dans la recherche de ChatGPT | Vous sortez des réponses de recherche de ChatGPT |
| GPTBot | OpenAI | Collecter des contenus pour entraîner les modèles | Vos textes quittent l'entraînement, la recherche ChatGPT n'est pas touchée |
| ChatGPT-User | OpenAI | Ouvrir une page à la demande d'un utilisateur | Effet limité, robots.txt peut ne pas s'appliquer |
| PerplexityBot | Perplexity | Référencer les sites dans les résultats de Perplexity | Vous sortez des résultats de Perplexity |
| Claude-SearchBot | Anthropic | Améliorer les réponses de recherche de Claude | Vos pages ne sont plus indexées pour ces réponses |
| ClaudeBot | Anthropic | Collecter des contenus pour l'entraînement | Vos futurs contenus quittent ses jeux de données |
| Google-Extended | Autoriser l'usage de vos pages pour entraîner Gemini | Aucun effet sur la Recherche Google |
Ces rôles viennent des documentations officielles d'OpenAI, qui sépare OAI-SearchBot et GPTBot, de Perplexity pour PerplexityBot et Perplexity-User et d'Anthropic pour ses trois robots.
Côté Google, Google-Extended n'a aucun effet sur la présence d'un site dans la Recherche. Il ne sert qu'à l'entraînement et au grounding des applications Gemini.
Le conseil d'Alexandre
Je vois souvent des sites qui bloquent « tous les robots IA » d'un coup, par prudence. Résultat : ils se ferment aussi la porte de la recherche de ChatGPT ou de Perplexity. Si vous voulez protéger vos textes, bloquez les robots d'entraînement (GPTBot, ClaudeBot), pas ceux de recherche.
Testez votre site
Pour apparaître dans les réponses de recherche de ChatGPT, quel robot doit pouvoir passer ?
C'est OAI-SearchBot. GPTBot sert à l'entraînement des modèles, et Google-Extended concerne Gemini.
Bloquer Google-Extended vous retire-t-il de la Recherche Google ?
Google l'écrit noir sur blanc : ce jeton n'affecte ni l'inclusion dans la Recherche ni le classement.
Selon Google, faut-il un balisage schema.org spécial pour ses réponses IA ?
Aucun balisage spécial n'est requis. Les données structurées restent utiles pour les résultats enrichis.
Les IA voient-elles vraiment vos pages ?
Voilà le piège le moins connu. La plupart des robots IA ne lisent que le HTML brut. Ils n'exécutent pas le JavaScript.
En décembre 2024, Vercel a observé un mois de trafic sur son réseau. Verdict : aucun des grands robots IA étudiés n'exécute le JavaScript, qu'il s'agisse des robots d'OpenAI, de ClaudeBot ou de PerplexityBot. Seuls Gemini, via l'infrastructure de Googlebot, et AppleBot font le rendu des pages.
Autrement dit, un texte qui s'affiche seulement après un script peut rester invisible pour ChatGPT ou Claude. Même s'il s'affiche parfaitement dans votre navigateur.
La même étude relève un autre signal : environ 34 % des requêtes de ChatGPT et de Claude tombaient sur des pages en erreur 404, contre un peu plus de 8 % pour Googlebot. Des redirections mal tenues et des liens cassés coûtent donc aussi des lectures.
À vérifier sur votre site
Ouvrez une page importante, puis affichez son code source (Ctrl + U). Si vos titres, vos prix ou vos réponses clés n'apparaissent pas dans ce code, une bonne partie des IA ne les voit pas non plus.
À quoi servent encore les données structurées ?
Les données structurées, c'est ce balisage schema.org qui décrit une page aux machines. Entreprise, auteur, article, FAQ, produit, avis…
Pendant des mois, j'ai lu partout qu'elles étaient indispensables pour être cité par les IA. Google a tranché. Dans son guide sur les fonctionnalités IA de la Recherche, il écrit qu'aucune donnée structurée schema.org spéciale n'est nécessaire pour apparaître dans les aperçus IA ou le Mode IA.
Son guide d'optimisation pour la recherche IA, mis à jour en juillet 2026, enfonce le clou : les données structurées ne sont pas requises pour la recherche IA générative. Elles restent utiles pour les résultats enrichis classiques.
Alors, je les jette ? Surtout pas. Je les garde pour ce qu'elles font bien :
- ➭ décrire clairement qui vous êtes (Organisation, adresse, fondateurs, réseaux) ;
- ➭ relier vos contenus à un auteur identifiable ;
- ➭ rester éligible aux résultats enrichis de Google.
Une règle compte plus que toutes les autres : le balisage doit correspondre au texte visible de la page. Google le rappelle dans ses consignes, et c'est là que beaucoup de plugins dérapent.
Pour contrôler, deux outils gratuits suffisent : le validateur schema.org et le test des résultats enrichis de Google. Pour le détail côté aperçus IA, on a une page dédiée à Google AI Overviews et au Mode IA.
Et le fichier llms.txt, on le met ou pas ?
Le fichier llms.txt est une proposition de Jeremy Howard publiée en septembre 2024. L'idée : un fichier Markdown à la racine du site, qui résume le site et liste ses pages utiles pour les modèles de langage.
Sur le papier, c'est séduisant. Dans les faits, c'est une proposition, pas un standard.
En juin 2025, John Mueller (Google) écrivait qu'aucun système d'IA n'utilisait llms.txt. Et le guide de Google de 2026 précise que la Recherche Google ne s'en sert pas, et que ce fichier n'aide ni ne nuit à la visibilité.
Ma position est simple. Un llms.txt coûte une heure, il ne fait pas de mal, mais il passe après tout le reste. Un robot bloqué ou une page invisible sans JavaScript pèse infiniment plus lourd.
(D'ailleurs, kontenu.fr n'en a pas. On préfère que nos robots.txt et notre HTML soient impeccables.)
Ce que je vérifie dans un audit GEO technique
Quand j'audite un site, je ne commence jamais par le balisage. Je suis cet ordre :
- ➭ L'indexation : vos pages clés sont-elles indexées et éligibles aux extraits dans Google et dans Bing ?
- ➭ Le robots.txt : les robots de recherche des IA passent-ils ? Les robots d'entraînement sont-ils bloqués si vous le souhaitez ?
- ➭ Le pare-feu : votre hébergeur ou votre CDN ne bloque-t-il pas ces robots sans vous le dire ?
- ➭ Le rendu : le contenu important est-il présent dans le HTML servi par le serveur ?
- ➭ Les erreurs : liens cassés, redirections en chaîne, pages orphelines ;
- ➭ Les données structurées : Organisation, auteurs, articles, cohérentes avec le texte visible.
Ensuite seulement, je passe au fond : les contenus, les sujets, les sources externes. C'est là que se gagnent les citations, avec notre accompagnement en référencement ChatGPT, et avec les relations presse que pilote Morgane.
Vous voulez savoir si les robots des IA lisent vraiment votre site ?
>>> Je demande un audit GEOCe qu'il faut retenir
- ➭ Laissez passer les robots de recherche des IA, bloquez seulement ceux d'entraînement si vous le voulez.
- ➭ Vérifiez que votre contenu clé existe dans le HTML, sans dépendre du JavaScript.
- ➭ Gardez des données structurées propres, sans attendre d'elles une citation dans les IA.
- ➭ Le llms.txt est facultatif, et il passe après tout le reste.
Questions fréquentes
Les données structurées améliorent-elles la visibilité dans ChatGPT ?
Aucun éditeur d'IA ne l'affirme officiellement. Google indique qu'elles ne sont pas requises pour ses réponses IA. Je les garde pour décrire clairement l'entreprise et pour les résultats enrichis, sans en attendre de miracle.
Faut-il bloquer GPTBot dans le robots.txt ?
C'est un choix. Bloquer GPTBot retire vos contenus de l'entraînement des modèles d'OpenAI, sans vous sortir de la recherche de ChatGPT, qui dépend d'OAI-SearchBot.
Un site WordPress fait avec Divi est-il lisible par les IA ?
En général oui, car WordPress et Divi produisent le HTML côté serveur. Il faut vérifier les blocs chargés après coup par un script, comme certains onglets, carrousels ou widgets d'avis.
Combien de temps faut-il pour qu'un changement de robots.txt soit pris en compte ?
OpenAI parle d'environ 24 heures pour la recherche de ChatGPT, et Perplexity d'un délai pouvant aller jusqu'à 24 heures.